Le problème : un service discret, mais central
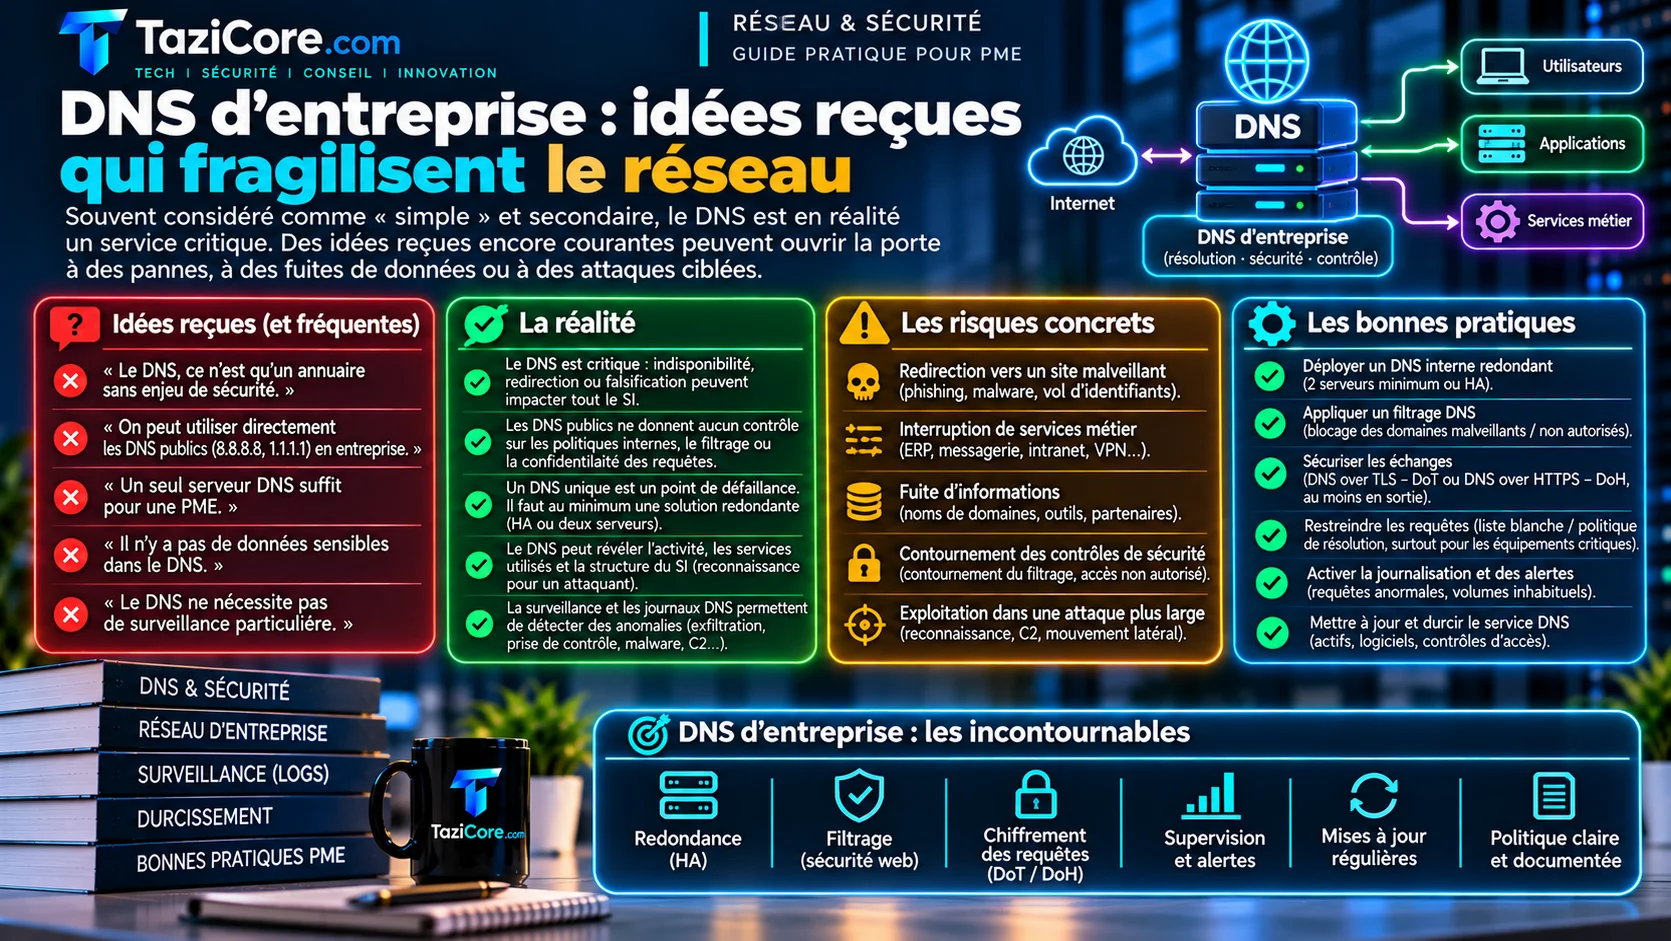
Le DNS est souvent perçu comme un composant d’arrière-plan : tant que les noms se résolvent, le sujet semble clos. C’est précisément ce qui le rend risqué. Dans un environnement professionnel, il relie les postes, les serveurs, les applications, les annuaires, les équipements réseau, les services cloud et parfois les objets connectés. Quand il est mal conçu, les symptômes apparaissent ailleurs : lenteurs applicatives, authentification instable, supervision bruyante, bascules incomplètes, erreurs de certificats ou accès aléatoires.
Le sujet n’est pas seulement technique. Un DNS interne confus ralentit les équipes, rend les incidents difficiles à analyser et augmente la dépendance à quelques personnes qui connaissent « les noms qui marchent ». À l’inverse, une architecture DNS documentée, testée et cohérente rend le réseau plus lisible et plus résilient.
Idées reçues fréquentes, et ce qu’il en est vraiment
« Le DNS est juste un annuaire »
C’est plus qu’un annuaire. Le DNS participe au routage logique des usages : il oriente les clients vers les bons services, distingue parfois les vues internes et externes, facilite les bascules et conditionne le bon fonctionnement de nombreux protocoles. Le traiter comme une simple table de correspondance conduit souvent à accumuler des enregistrements historiques, non documentés ou contradictoires.
La bonne approche consiste à gérer le DNS comme une partie de l’infrastructure : avec des propriétaires identifiés, des règles de nommage, un cycle de changement et une supervision adaptée.
« Si Internet fonctionne, le DNS interne fonctionne »
Résoudre des noms publics et résoudre correctement des noms internes sont deux sujets différents. Une entreprise peut accéder au web tout en ayant un DNS interne fragile : zones incomplètes, délégations mal pensées, suffixes incohérents, résolveurs configurés différemment selon les sites ou dépendance non maîtrisée à des serveurs externes.
Il faut distinguer clairement les rôles : les serveurs faisant autorité pour les zones internes, les résolveurs récursifs utilisés par les clients, les redirecteurs éventuels et les services DNS fournis par des plateformes externes. Mélanger ces rôles sans règle claire complique les diagnostics.
« Un TTL court règle les problèmes de bascule »
Le TTL aide à contrôler la durée de vie d’une réponse en cache, mais il ne remplace pas une stratégie de haute disponibilité. Des clients, des applications ou des équipements peuvent conserver des informations plus longtemps que prévu, ou ne pas réessayer comme attendu. Une bascule fondée uniquement sur une modification DNS peut donc produire des comportements hétérogènes.
Avant de s’appuyer sur le DNS pour une bascule, il faut tester le scénario complet : application, client, cache local, résolveur, supervision et retour arrière. Le TTL est un paramètre utile, pas une garantie de continuité.
« Les journaux DNS ne servent qu’en cas d’incident »
Les journaux DNS peuvent aider à comprendre les usages, détecter des erreurs de configuration, repérer des requêtes inattendues ou confirmer qu’une migration se déroule correctement. Mais ils doivent être exploités avec mesure : ils peuvent révéler des habitudes de navigation, des noms d’applications internes ou des informations sensibles sur l’organisation.
La bonne pratique consiste à définir ce qui est journalisé, pendant combien de temps, par qui c’est consulté et dans quel objectif. La sécurité ne dispense pas d’une réflexion sur la confidentialité et la proportionnalité.
« Bloquer le port DNS classique suffit »
Le contrôle des flux DNS est utile, mais il ne suffit pas toujours. Certains systèmes ou navigateurs peuvent utiliser des mécanismes de résolution chiffrée, selon leur configuration. Des applications peuvent aussi embarquer leurs propres choix de résolution. L’objectif n’est pas de bloquer aveuglément, mais d’établir une politique claire : quels résolveurs sont autorisés, quels usages sont acceptés, comment les exceptions sont validées et comment les écarts sont détectés.
Un réseau d’entreprise gagne à faire passer les clients par des résolveurs maîtrisés, capables d’appliquer les règles de sécurité, de journaliser ce qui doit l’être et d’offrir un comportement homogène.
« DNSSEC chiffre les requêtes DNS »
DNSSEC ne doit pas être confondu avec le chiffrement du transport. Son rôle est de contribuer à l’authenticité et à l’intégrité des réponses DNS dans les zones qui l’utilisent correctement. Il ne rend pas les requêtes invisibles et ne remplace pas une politique de confidentialité, de filtrage ou de supervision.
Lorsqu’il est pertinent, DNSSEC doit être intégré avec soin : validation côté résolveur, gestion des clés, surveillance des erreurs et procédure de renouvellement. Une mise en œuvre partielle ou mal suivie peut créer des pannes difficiles à diagnostiquer.
Ce qu’il faut faire
La première étape consiste à cartographier le DNS réel, pas seulement le DNS supposé. Il faut identifier les zones internes et publiques, les serveurs faisant autorité, les résolveurs utilisés par les postes, les dépendances avec l’annuaire, le DHCP, les services cloud, les VPN et les sites distants.
Ensuite, il faut clarifier les responsabilités. Qui crée un nom ? Qui valide sa suppression ? Qui peut modifier une zone ? Qui intervient en cas d’erreur ? Sans règles simples, le DNS devient rapidement un empilement de décisions locales.
Les bonnes pratiques incluent aussi la séparation des usages. Les zones publiques et internes doivent être pensées selon des besoins différents. Les transferts de zone doivent être limités aux systèmes autorisés. Les mises à jour dynamiques, lorsqu’elles existent, doivent être encadrées. Les résolveurs utilisés par les clients doivent être connus, supervisés et configurés de façon cohérente.
Enfin, le DNS doit être testé comme tout autre service critique. Il ne suffit pas de vérifier qu’un nom répond. Il faut tester la perte d’un résolveur, une erreur de délégation, une modification de zone, une bascule applicative, un renouvellement de certificat et le comportement depuis plusieurs emplacements réseau.
Les pièges à éviter
- Créer des noms au fil de l’eau sans convention stable : cela complique l’exploitation et favorise les doublons.
- Laisser d’anciens enregistrements après une migration : ils peuvent masquer des erreurs ou maintenir des dépendances oubliées.
- Configurer des DNS différents selon les équipes : les incidents deviennent difficiles à reproduire.
- Oublier les zones inverses : elles restent utiles pour certains diagnostics, journaux et contrôles.
- Confondre filtrage DNS et sécurité complète : le DNS est un point de contrôle, pas une protection suffisante à lui seul.
- Ne jamais tester les caches : un changement correct côté serveur peut rester invisible côté client pendant un certain temps.
Par où commencer
- Inventorier les résolveurs réellement utilisés par les postes, serveurs, VPN, équipements réseau et environnements cloud, puis supprimer les configurations incohérentes.
- Documenter les zones et les responsabilités : propriétaire, usage, règles de modification, politique de suppression et contacts d’exploitation.
- Tester les scénarios de panne et de changement : perte d’un résolveur, modification d’un enregistrement critique, bascule applicative et retour arrière.