Le problème dans une petite structure
Dans une PME, une application démarre souvent avec une équipe réduite, des délais courts et des environnements qui se construisent progressivement. Le risque est alors de traiter les secrets applicatifs comme de simples paramètres techniques : mot de passe de base de données, clé d’API, jeton d’accès, certificat, chaîne de connexion ou clé privée.
Le problème n’est pas seulement leur existence. Une application a besoin de s’authentifier auprès de services tiers, de bases de données ou d’outils internes. Le vrai sujet est la manière dont ces secrets sont créés, stockés, partagés, utilisés, renouvelés et supprimés. Une erreur de développement peut suffire à exposer un accès sensible : secret écrit dans le code, commité dans un dépôt, copié dans un ticket, affiché dans des journaux ou réutilisé sur plusieurs environnements.
Pour un dirigeant, l’enjeu est opérationnel : éviter qu’un incident technique se transforme en interruption de service, fuite de données, perte de confiance ou difficulté de conformité. Pour une équipe technique, l’objectif est plus concret : mettre en place des pratiques simples, répétables et adaptées à la taille de l’organisation.
Ce qu’il faut faire
Identifier ce qui est réellement un secret
La première erreur consiste à ne protéger que les mots de passe humains. En développement, un secret peut prendre de nombreuses formes : clé d’accès à un service cloud, jeton d’intégration continue, clé de signature, secret OAuth, mot de passe de compte technique, fichier de certificat, variable d’environnement sensible ou URL contenant des identifiants.
Une règle pratique consiste à se poser une question simple : si cette valeur est publiée, permet-elle d’accéder à une ressource, d’usurper une application ou de contourner un contrôle ? Si oui, elle doit être gérée comme un secret.
Séparer le code et la configuration sensible
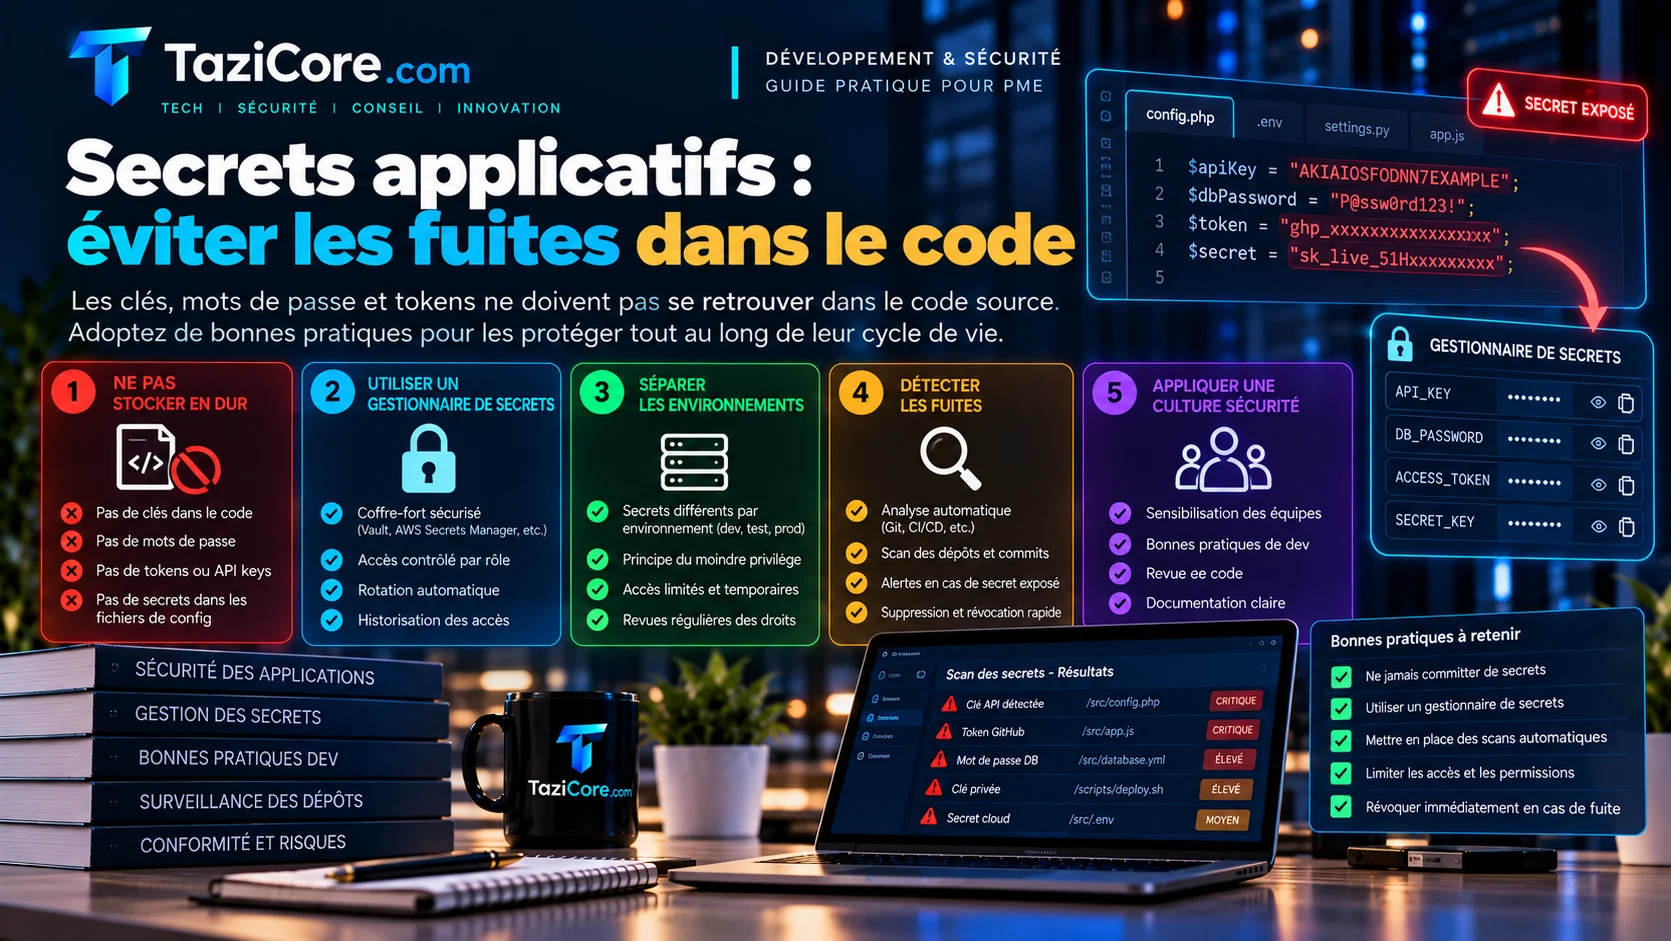
Un secret ne doit pas être écrit en dur dans le code source. Même dans un prototype, cette pratique finit souvent par rester, être copiée ou partir dans un dépôt partagé. Le code doit indiquer où récupérer le secret, pas contenir le secret lui-même.
En pratique, l’application peut charger ses paramètres sensibles depuis un mécanisme prévu à cet effet : variables d’environnement, coffre de secrets, service de configuration sécurisé, fichier local exclu du dépôt ou mécanisme propre à la plateforme d’exécution. Le choix dépend de l’architecture, mais le principe reste le même : le dépôt contient le code et des exemples non sensibles, jamais les valeurs réelles.
Créer des secrets différents par environnement
Un autre piège fréquent consiste à réutiliser le même mot de passe ou la même clé en développement, test, préproduction et production. Cette facilité augmente l’impact d’une fuite : un secret exposé sur un poste de développement peut alors ouvrir l’accès à la production.
Chaque environnement doit disposer de secrets distincts. Le développeur peut travailler avec des valeurs locales limitées. Les tests automatisés peuvent utiliser des secrets dédiés et révocables. La production doit avoir ses propres secrets, accessibles uniquement aux services et personnes qui en ont besoin.
Limiter les droits associés aux secrets
Un secret ne doit pas donner plus de droits que nécessaire. Si une application lit seulement des données, son compte technique ne devrait pas pouvoir supprimer des tables, administrer un service ou créer d’autres comptes. Cette logique réduit les conséquences d’une erreur ou d’un secret exposé.
Il est utile de raisonner par usage : un secret pour l’application web, un autre pour les traitements planifiés, un autre pour les sauvegardes, un autre pour l’intégration continue. Cette séparation demande un peu de discipline, mais facilite l’audit, la révocation et l’analyse en cas d’anomalie.
Prévoir la rotation dès le départ
Un secret doit pouvoir être remplacé sans réécrire l’application ni interrompre durablement le service. C’est souvent oublié dans les petits projets : le secret fonctionne, donc personne ne prévoit son renouvellement. Le jour où il faut le changer, l’équipe découvre qu’il est dupliqué dans plusieurs fichiers, scripts et environnements.
La bonne pratique consiste à documenter l’emplacement de chaque secret, son usage, son responsable fonctionnel ou technique, et la procédure de remplacement. Quand c’est possible, l’application doit tolérer une période de transition, par exemple avec deux clés valides pendant un changement contrôlé.
Empêcher les fuites dans les journaux et les erreurs
Les journaux applicatifs sont utiles pour diagnostiquer un incident, mais ils deviennent dangereux s’ils affichent les secrets. Une erreur classique est de journaliser une configuration complète, une requête HTTP avec en-têtes d’autorisation, une URL contenant un jeton ou une exception qui révèle une chaîne de connexion.
Les équipes doivent masquer les valeurs sensibles avant journalisation. Les noms de champs comme password, token, secret, authorization ou api_key doivent déclencher une vigilance particulière. Il est préférable de journaliser un identifiant technique, un statut ou un horodatage plutôt que la valeur confidentielle elle-même.
Les pièges à éviter
Considérer un dépôt privé comme un coffre-fort
Un dépôt privé n’est pas un gestionnaire de secrets. Il peut être cloné sur plusieurs postes, sauvegardé, intégré à des outils tiers ou consulté par plusieurs profils. Une fois un secret commité, il peut rester présent dans l’historique même si la ligne est supprimée ensuite. La suppression visible ne suffit donc pas toujours : il faut considérer le secret comme compromis et le remplacer.
Partager les secrets par messagerie ou ticket
Envoyer un mot de passe dans un courriel, une messagerie instantanée ou un ticket de support paraît pratique, mais laisse des copies dans des systèmes qui n’ont pas été conçus pour stocker ce type d’information. Il vaut mieux utiliser un mécanisme de partage temporaire et contrôlé, ou donner accès au coffre adapté plutôt que transmettre la valeur elle-même.
Oublier les postes de développement
Les postes des développeurs contiennent parfois des fichiers .env, des clés SSH, des jetons d’outillage et des accès à des environnements de test. Ils font partie de la surface d’exposition. Les secrets locaux doivent être limités, documentés, exclus du dépôt et supprimés lorsqu’ils ne sont plus nécessaires.
Automatiser sans contrôler
L’intégration continue et le déploiement automatisé améliorent la fiabilité, mais ils manipulent souvent des secrets puissants. Un jeton de pipeline mal limité peut devenir un point d’accès majeur. Les droits des comptes techniques doivent être réduits, les variables sensibles protégées et les journaux de pipeline vérifiés pour éviter l’affichage accidentel de valeurs confidentielles.
Par où commencer
- Rechercher les secrets déjà exposés. Examiner les dépôts, scripts, fichiers de configuration, journaux et tickets techniques. Tout secret découvert dans un emplacement inadapté doit être remplacé, pas seulement supprimé.
- Mettre en place une règle de séparation. Interdire les secrets dans le code source et définir un mécanisme unique par environnement : variables protégées, coffre de secrets ou configuration sécurisée selon l’infrastructure en place.
- Documenter la rotation. Pour chaque secret important, préciser son usage, son emplacement, les droits associés et la procédure de renouvellement. Cette documentation doit être assez simple pour être appliquée en situation d’urgence.