Le problème : sauvegarder sans savoir restaurer
Dans beaucoup de petites structures, la sauvegarde existe : un disque externe, un espace cloud, une tâche planifiée sur un serveur, parfois plusieurs outils selon les applications. Le risque n’est pas seulement l’absence de sauvegarde. Il est aussi de découvrir trop tard que les données sont incomplètes, que les droits ne suivent pas, que la procédure dépend d’une seule personne ou que le temps de remise en service est incompatible avec l’activité.
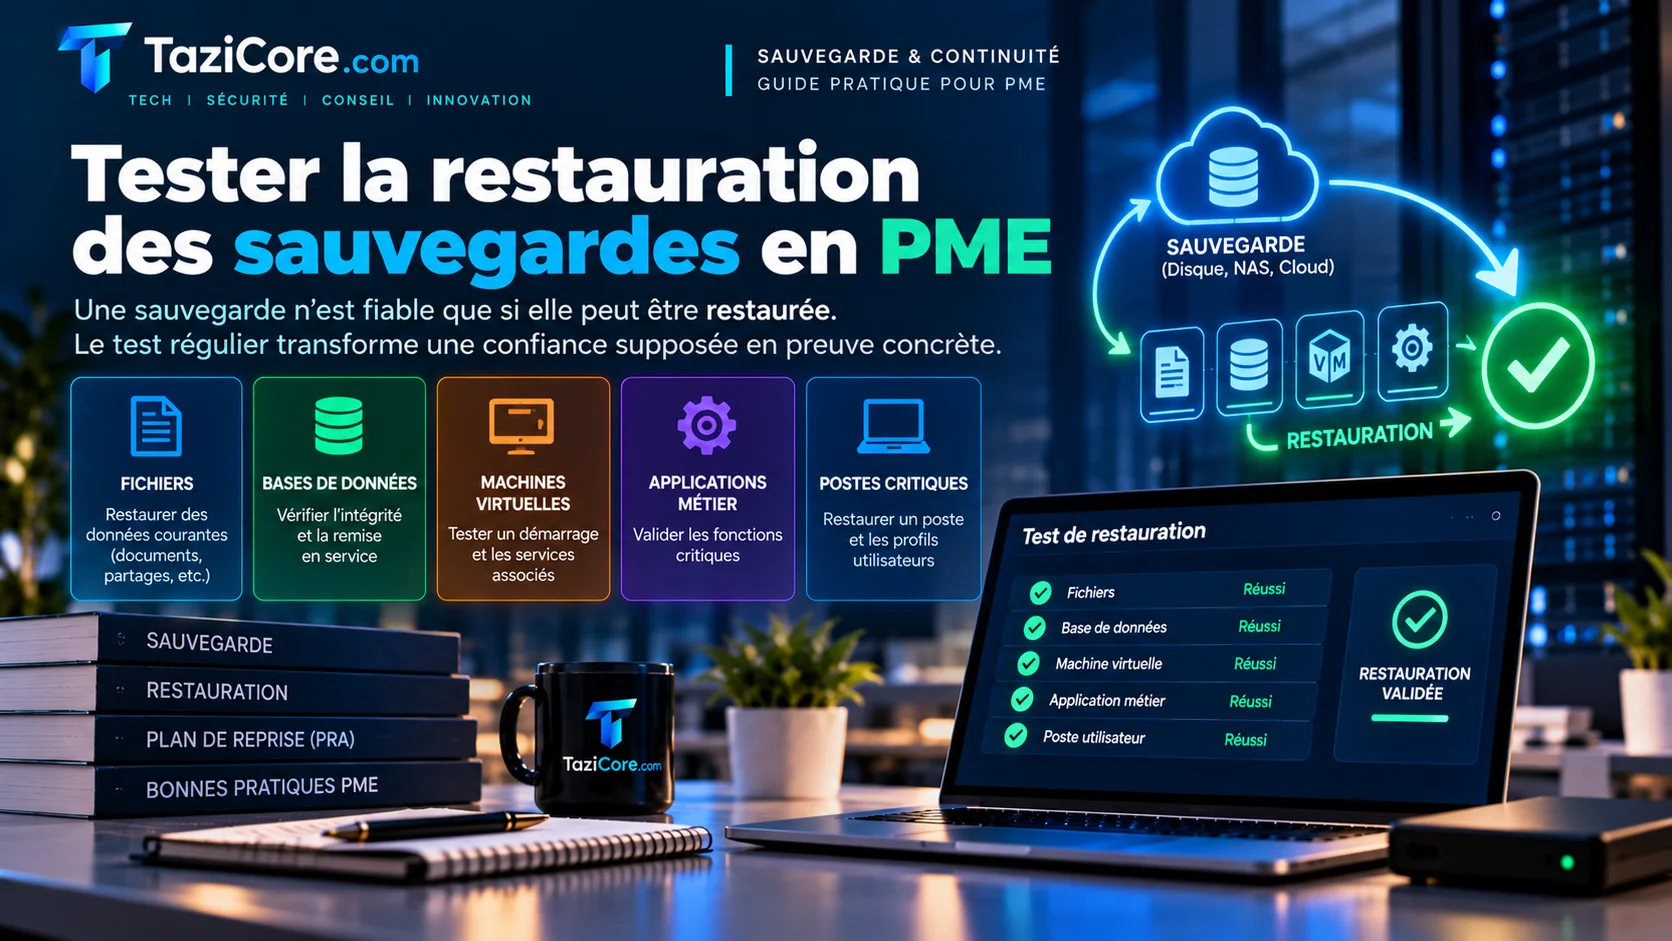
Le test de restauration est un sujet de validation très concret. Il consiste à vérifier, dans des conditions maîtrisées, qu’une sauvegarde peut réellement être utilisée pour récupérer un fichier, une base de données, une machine virtuelle, une application métier ou un poste critique. Pour une PME, l’objectif n’est pas de bâtir un laboratoire complexe, mais de transformer une confiance supposée en vérification régulière et documentée.
Erreur fréquente n°1 : confondre sauvegarde réussie et restauration possible
Un rapport de sauvegarde marqué comme réussi indique surtout que l’outil a terminé une tâche. Cela ne prouve pas que les données restaurées seront lisibles, cohérentes ni exploitables par l’application. Par exemple, récupérer un répertoire de fichiers ne suffit pas si l’application a aussi besoin d’une base, d’un certificat, d’un compte de service, de paramètres réseau ou d’une clé de chiffrement.
La bonne pratique consiste à définir des scénarios de restauration simples et représentatifs. Il peut s’agir de restaurer un fichier supprimé, de récupérer un dossier partagé, de remettre en route une base de test à partir d’une sauvegarde ou de reconstruire une machine non critique. Chaque scénario doit préciser ce qui est restauré, où, par qui, avec quels droits, et comment le résultat est contrôlé.
Erreur fréquente n°2 : tester seulement les cas faciles
Les petites structures testent souvent la restauration d’un document isolé, car c’est rapide et rassurant. C’est utile, mais insuffisant. Les incidents qui gênent réellement l’activité concernent souvent un ensemble : application, données, configuration, accès, dépendances réseau et comptes associés. Un test limité aux fichiers ne valide pas la reprise d’un service complet.
Il faut classer les éléments par criticité métier. Les premiers scénarios doivent couvrir ce qui bloque le plus vite l’entreprise : facturation, production, messagerie, accès aux dossiers clients, outil de planification, serveur de fichiers, annuaire ou application interne. Pour chaque élément, il faut identifier les dépendances minimales : stockage, base de données, compte administrateur, paramètres DNS, secrets, certificats, connecteurs et documentation éditeur.
Erreur fréquente n°3 : restaurer directement en production
Un test de restauration ne doit pas créer un nouvel incident. Restaurer une base ou une machine au mauvais endroit peut écraser des données, perturber des utilisateurs ou créer des doublons. C’est particulièrement sensible lorsque l’environnement de test ressemble à la production sans être clairement isolé.
La méthode prudente consiste à préparer une zone de restauration dédiée : machine isolée, réseau de test, espace de stockage séparé ou environnement applicatif temporaire. Les accès doivent être limités aux personnes concernées. Si des données personnelles ou sensibles sont utilisées, il faut éviter de les exposer inutilement, limiter les copies et supprimer l’environnement de test après validation lorsque sa conservation n’est pas justifiée.
Erreur fréquente n°4 : oublier les preuves de validation
Un test non documenté est difficile à reproduire. Lorsqu’un incident survient, l’équipe perd du temps à rechercher la bonne console, le bon compte, le bon chemin de sauvegarde ou l’ordre des opérations. La documentation ne doit pas être longue, mais elle doit être utilisable sous pression.
Un compte rendu de test peut tenir en une page. Il doit indiquer la date, le périmètre, la sauvegarde utilisée, l’emplacement de restauration, la personne ayant exécuté l’opération, le résultat attendu, le résultat constaté, les anomalies et les actions correctives. Pour une application, il faut ajouter un contrôle fonctionnel : ouverture de session, consultation d’un enregistrement, génération d’un document, démarrage d’un service ou vérification par un utilisateur référent.
Erreur fréquente n°5 : dépendre d’une seule personne
Dans une petite structure, la connaissance de la sauvegarde repose parfois sur le dirigeant, un prestataire, un administrateur ou un collaborateur expérimenté. Cette dépendance devient critique en cas d’absence, de départ ou d’urgence. Le test de restauration doit donc aussi valider la transmission du savoir.
Une bonne approche consiste à faire exécuter périodiquement la procédure par une autre personne habilitée, sous supervision. Si cette personne ne comprend pas une étape, la documentation doit être corrigée. Les mots de passe, clés de chiffrement, comptes de secours et accès aux consoles doivent être gérés de façon sécurisée, mais disponibles aux personnes autorisées selon une procédure prévue à l’avance.
Erreur fréquente n°6 : ne pas décider de critères d’acceptation
Dire qu’un test est réussi reste ambigu si aucun critère n’a été défini. Une restauration peut fonctionner techniquement tout en étant trop lente, incomplète ou inutilisable par le métier. Les critères doivent être simples : données présentes, service démarré, utilisateurs capables de se connecter, journal d’erreur acceptable, application cohérente, temps de restauration observé et écarts notés.
Il est préférable de distinguer deux notions. Le besoin métier décrit ce que l’entreprise veut récupérer et dans quel ordre. Le test technique vérifie ce qui est réellement possible avec l’architecture existante. L’écart entre les deux doit être visible. Il permet d’arbitrer : améliorer l’outil, modifier la fréquence de sauvegarde, documenter une étape, automatiser une partie ou accepter une dégradation temporaire en connaissance de cause.
Ce qu’il faut mettre en place
- Un inventaire de restauration : applications, données, emplacements, dépendances, responsables et niveau de criticité.
- Un calendrier de tests : quelques scénarios courts, planifiés, couvrant progressivement les services essentiels.
- Un environnement de test isolé : même minimal, il réduit le risque de perturber la production.
- Des procédures courtes : étapes numérotées, accès nécessaires, commandes utiles, points de contrôle.
- Un compte rendu systématique : succès, échecs, temps observé, corrections à prévoir.
- Une revue après changement : toute migration, nouvelle application, modification de stockage ou changement de compte doit amener à vérifier que la sauvegarde et la restauration restent valides.
Les pièges à éviter
- Tester uniquement l’outil et pas le retour au service attendu par les utilisateurs.
- Supposer que le cloud remplace le test : même avec un service externalisé, les paramètres, droits, erreurs humaines et dépendances doivent être vérifiés.
- Oublier les secrets : sans clé, mot de passe, certificat ou compte de service, certaines restaurations peuvent rester inutilisables.
- Conserver indéfiniment les copies de test : elles peuvent contenir des données sensibles et doivent être maîtrisées.
- Ne pas traiter les échecs : un test raté est utile seulement si une action corrective est décidée et suivie.
Par où commencer
- Restaurer un dossier critique dans un emplacement isolé, puis vérifier avec un utilisateur métier que les fichiers sont lisibles et exploitables.
- Choisir une application essentielle et rédiger sa procédure minimale de reprise : données, dépendances, comptes, contrôles fonctionnels et ordre des opérations.
- Planifier un test périodique court avec compte rendu, en élargissant progressivement le périmètre aux services les plus sensibles.