Avant d’ouvrir une application critique ou une mise à jour majeure aux utilisateurs, s’assurer de sa stabilité sous fort trafic constitue une étape technique incontournable. Les tests de charge permettent de vérifier le comportement des systèmes face à une volumétrie d’usage anticipée ou exceptionnelle. Toutefois, une campagne de test mal calibrée ou des données mal interprétées créent un faux sentiment de sécurité qui se traduit fréquemment par des pannes directes en production.
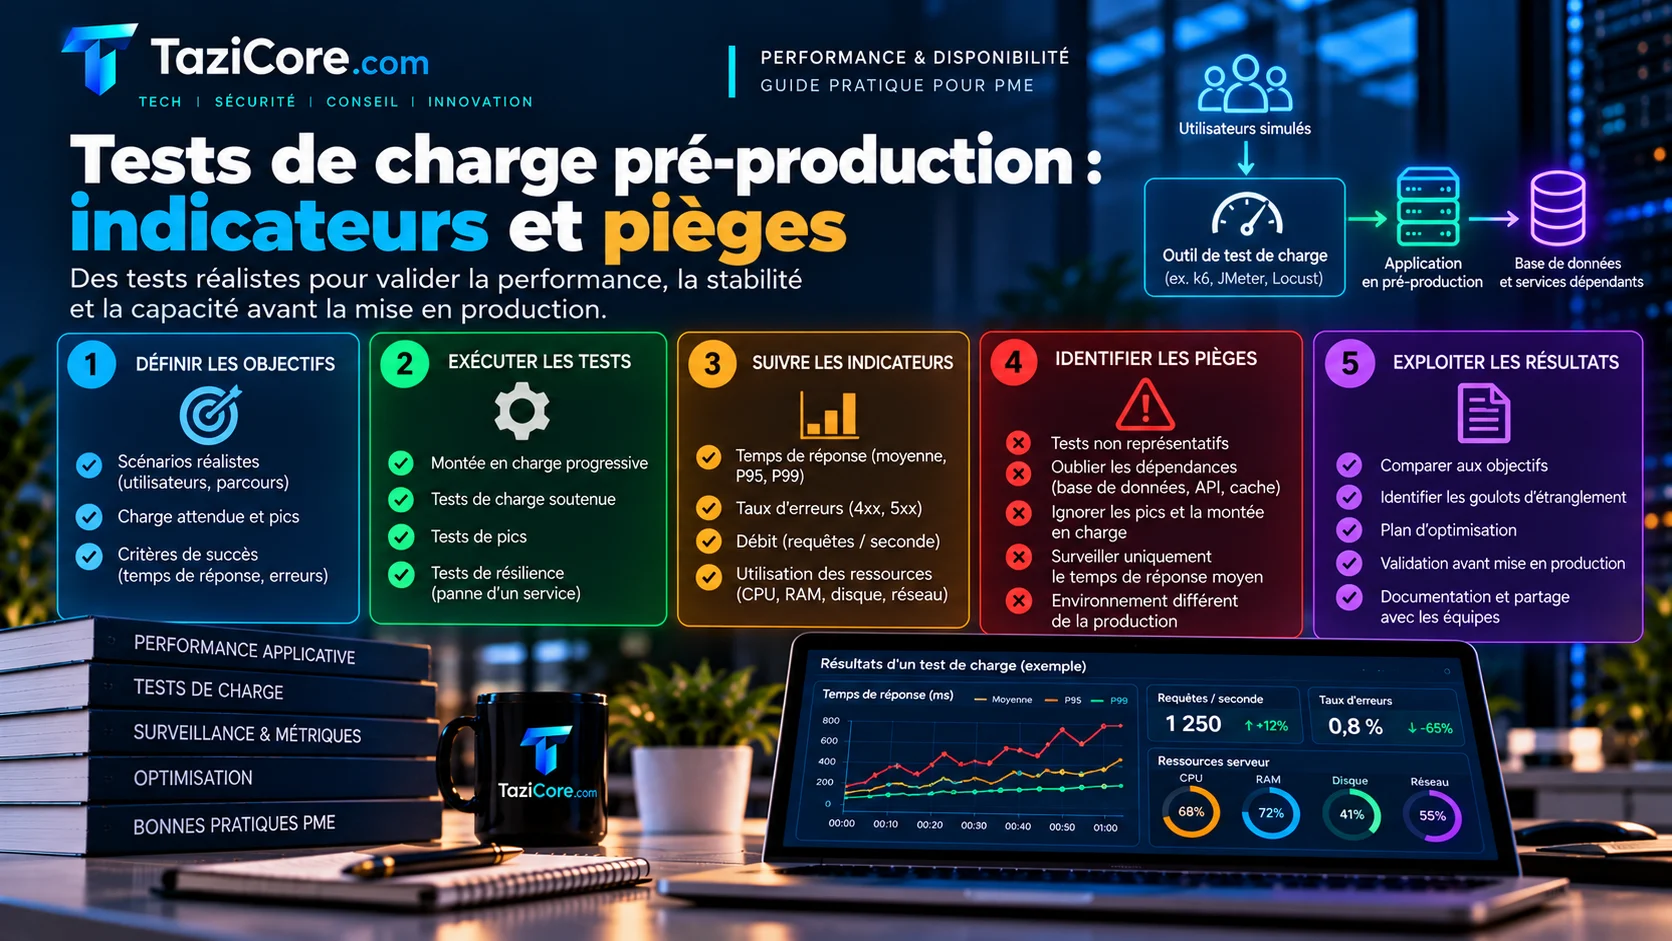
Les indicateurs essentiels à mesurer
Une campagne d’évaluation rigoureuse nécessite d’analyser conjointement deux angles d’observation : la perspective cliente et la perspective système côté serveur.
- Le débit (Throughput) : exprimé en requêtes par seconde (RPS) ou transactions par seconde, il quantifie le volume de travail que l’application traite effectivement sur une fenêtre donnée.
- Les temps de réponse et la latence : ils représentent la durée totale nécessaire au traitement d’une requête, perçue depuis l’injecteur de charge.
- Le taux d’erreur : la proportion de codes d’état HTTP anormaux (erreurs 5xx, timeouts réseau ou échecs applicatifs) par rapport à l’ensemble du trafic transmis.
- L’utilisation des ressources système : les métriques des composants d’infrastructure (processeur, consommation mémoire, bande passante réseau, connexions aux bases de données et files d’attente).
Comment lire et interpréter les résultats
L’analyse des résultats ne doit pas se limiter à une simple moyenne globale. D’après les recommandations architecturales publiées par Microsoft, la définition explicite de critères de succès et d’échec (« pass/fail criteria ») portant sur le débit, les percentiles de latence, les taux d’erreur et la saturation des ressources est indispensable pour évaluer objectivement la fiabilité d’une charge de travail.
Bannir la moyenne au profit des percentiles
La moyenne arithmétique masque couramment les incidents de performance. Si 95 % des requêtes s’exécutent en 100 millisecondes mais que les 5 % restants mettent 8 secondes, la moyenne semblera satisfaisante alors qu’un utilisateur sur vingt subit une lenteur inacceptable. Il convient donc d’observer les percentiles p95, p99 ou p99.9 pour quantifier précisément la « latence de queue » (tail latency) subie par les requêtes les plus lentes.
Observer les points de rupture et corrélations
L’analyse consiste à croiser les courbes d’injection avec les métriques d’infrastructure. Une stagnation du débit alors que l’injecteur augmente le nombre d’utilisateurs virtuels signale un goulot d’étranglement. Si le taux d’erreur commence à croître ou si la consommation processeur d’une dépendance atteint un plateau, le composant limitant est directement localisé.
Les pièges les plus fréquents
Plusieurs biais méthodologiques faussent fréquemment les conclusions d’un test de charge :
- Tester sur un environnement sous-dimensionné : exécuter les tirs de charge sur une infrastructure réduite sans modèle de transposition direct empêche d’anticiper le comportement réel des systèmes distribués et des pools de connexions.
- Utiliser des jeux de données irréalistes : solliciter en boucle un identifiant unique ou une page statique génère des lectures systématiques en mémoire cache (RAM ou tampon de base de données), faussant la mesure des temps de calcul réels et des accès disques.
- Ignorer la saturation de l’injecteur de charge : si la machine qui génère les requêtes sature ses propres ressources processeur ou sockets réseau, les latences mesurées reflètent la faiblesse de l’outil de test et non celle de la cible.
- Négliger les tiers et dépendances : omettre de tester les files de messages ou les systèmes d’arrière-plan expose l’application à un écroulement asynchrone dès que les traitements différés s’accumulent.
Par où commencer
- Définir les critères d’acceptation objectifs : fixer les seuils cibles de débit, de taux d’erreur maximal et de temps de réponse aux percentiles p95 et p99 en lien avec les exigences opérationnelles du métier.
- Concevoir des scénarios et jeux de données représentatifs : construire des scripts de test simulant des parcours utilisateurs variés et injecter des données dynamiques pour éviter le contournement des accès disques par la mémoire cache.
- Configurer la surveillance complète avant le premier tir : instrumenter chaque composant technique (serveurs web, applicatifs, bases de données, réseaux) pour enregistrer simultanément les métriques clientes et la saturation des ressources système.